
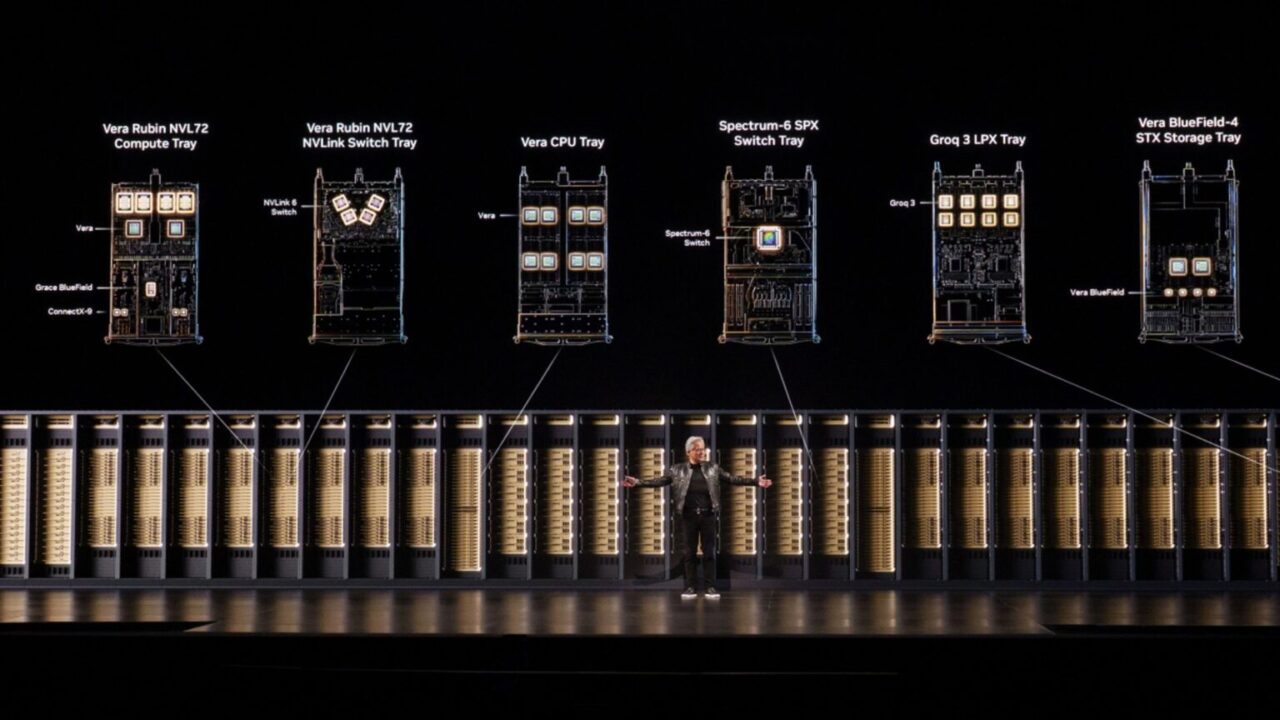
Größere Modelle, längere Kontexte und agentische Anwendungen erhöhen den Druck auf GPU-Speicher, während das Angebot enger wird und die Preise steigen – ein Trend, der sich auf kurze Sicht fortsetzen wird.
NVIDIA arbeitet eng mit Speicherpartnern zusammen, um die neuesten Speichertechnologien schnell zu übernehmen. NVIDIA hat als erstes Unternehmen HBM3e- und HBM4-Technologien in einen beschleunigten Computing-Stack integriert.
Aber der Ansatz besteht nicht darin, einfach mehr Speicher auf der GPU unterzubringen. Es handelt sich um Full-Stack-Codesign. NVIDIA entwickelt GPUs, CPUs, Netzwerke, Datenspeicher und Software bewusst zusammen, um auf jeder Ebene der KI-Fabrik effizientere Arbeit aus dem Speicher zu erzielen.
Das ist wichtig, da eine KI-Fabrik auf einer Speicher- und Datenspeicherhierarchie basiert. GPU-Speicher mit hoher Bandbreite (HBM) ist die schnellste, teuerste und am meisten umkämpfte Ebene, wobei Modellgewichte und KV-Cache um begrenzte Kapazität konkurrieren. Darunter befinden sich CPU-Speicher, lokale SSDs und gemeinsam genutzter Datenspeicher, die jeweils Geschwindigkeit gegen mehr Kapazität zu geringeren Kosten pro Bit eintauschen.
Wie viel nützliche Arbeit ein Byte leistet, hängt davon ab, wie gut die gesamte Hierarchie genutzt wird: was gespeichert werden muss, zu reduzieren, auf die richtige Ebene zu bringen und zur GPU zurückzuholen, bevor es benötigt wird.
Byte für Byte nutzt NVIDIA den Speicher auf jeder Ebene am effizientesten – und die Ergebnisse zeigen es. Von NVIDIA Blackwell Ultra bis hin zur Vera Rubin-Plattform stieg die HBM-Kapazität pro GPU um etwa 3 %, während der agentische Durchsatz pro Dollar bei SemiAnalysis AgentX um das bis zu 30-Fache stieg.
Agentische Inferenz setzt HBM mehr unter Druck
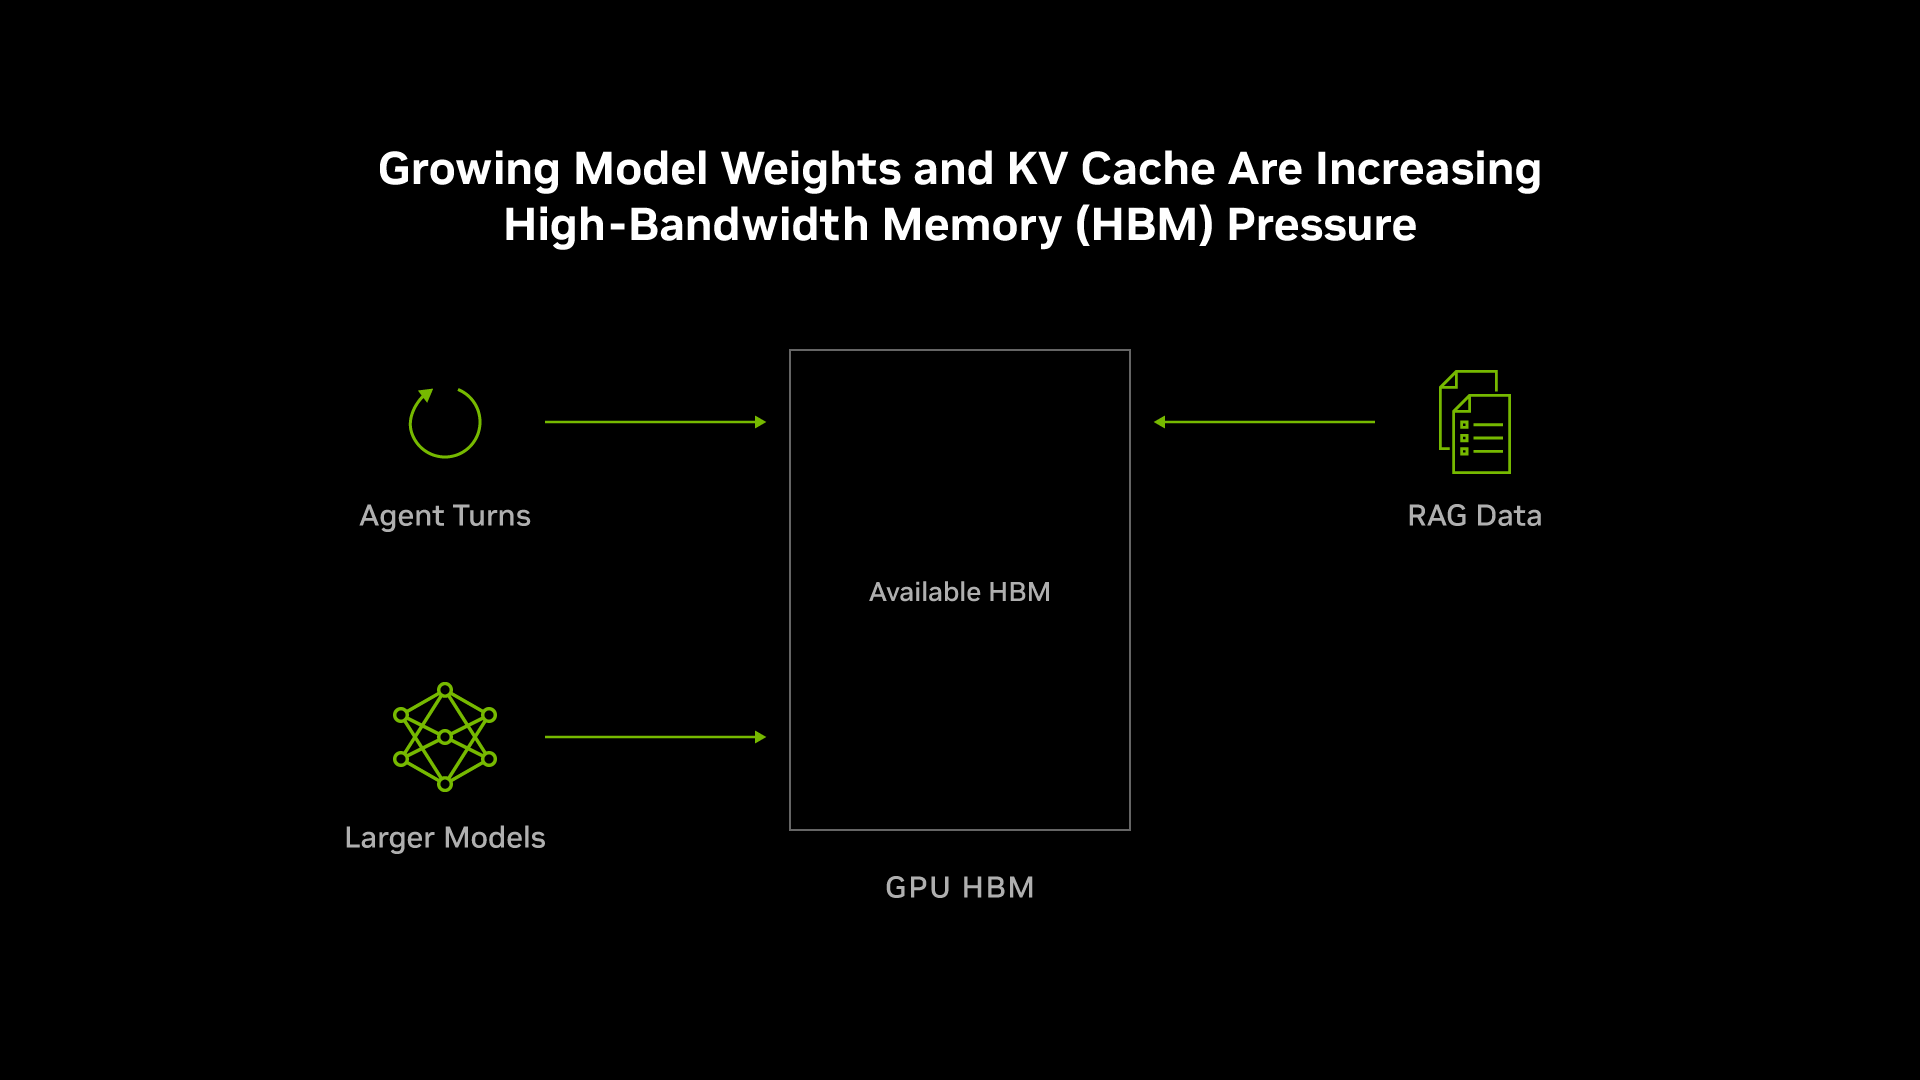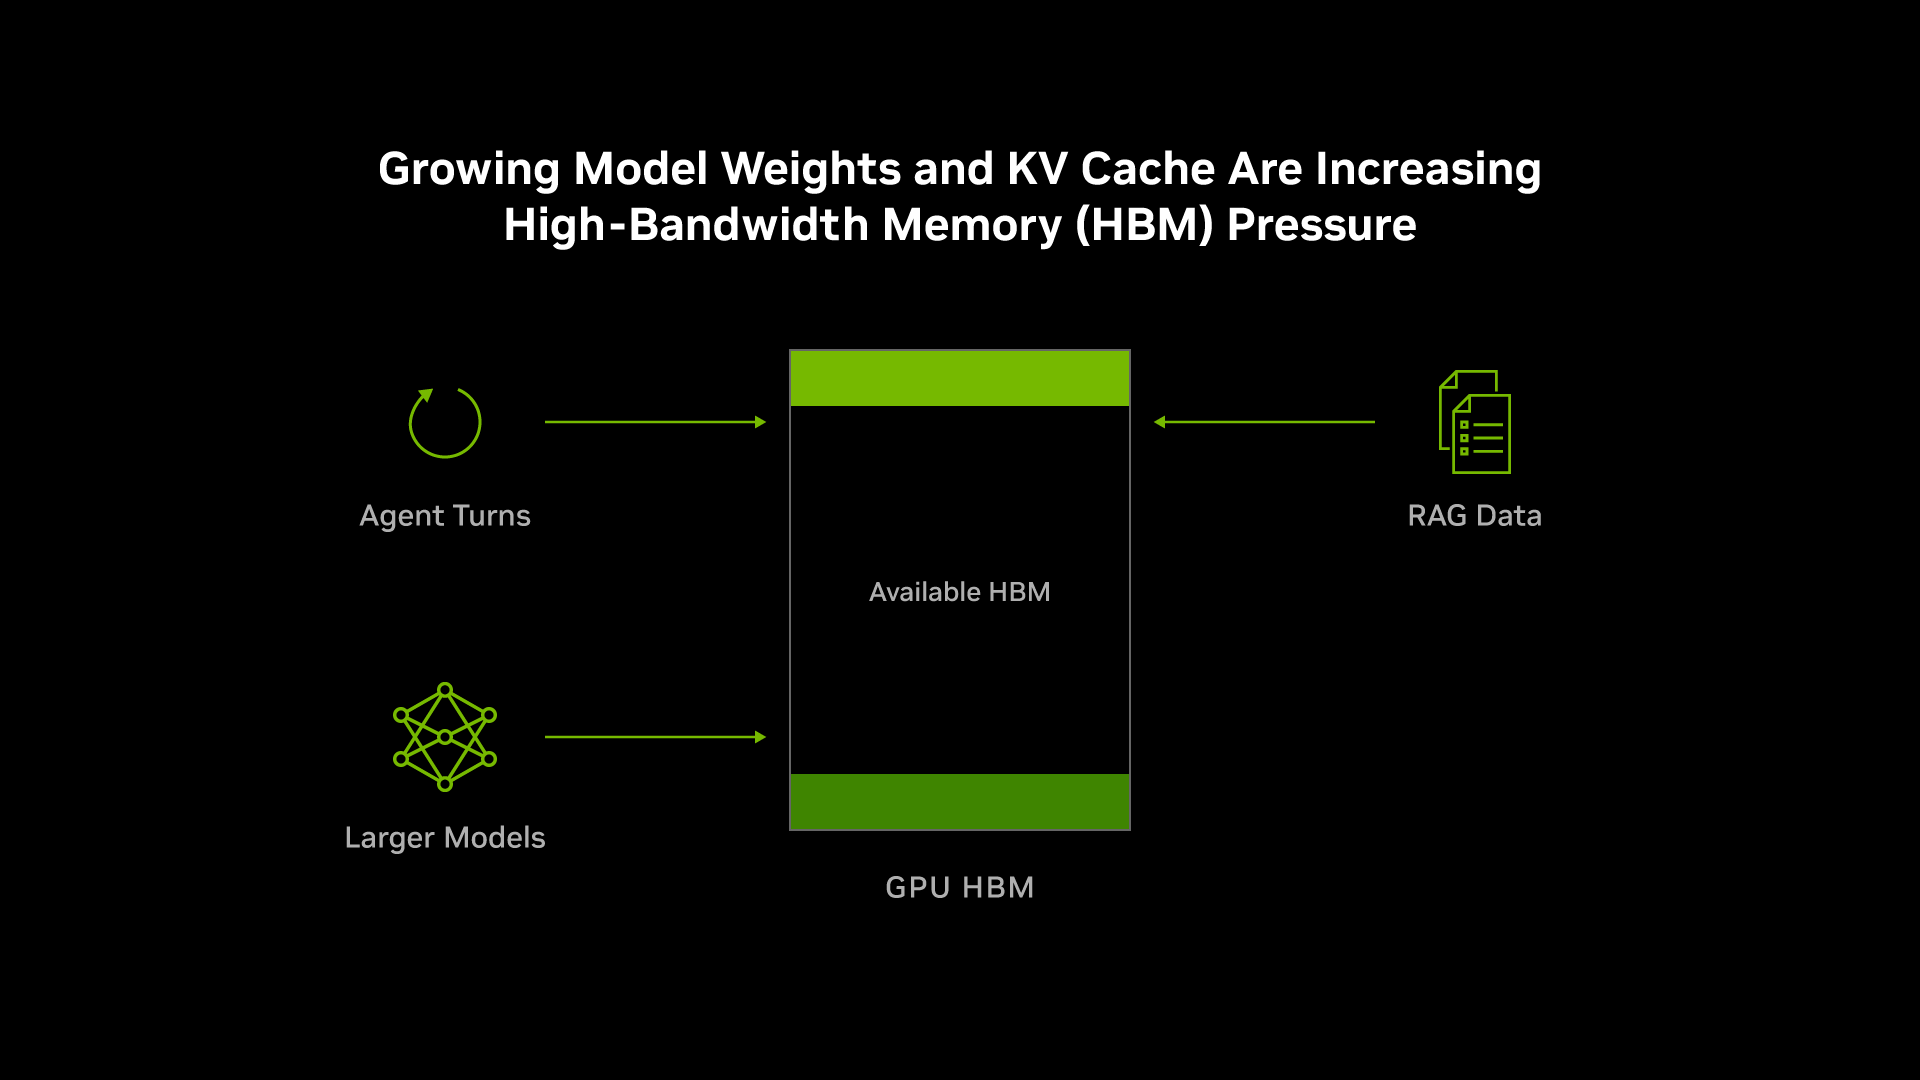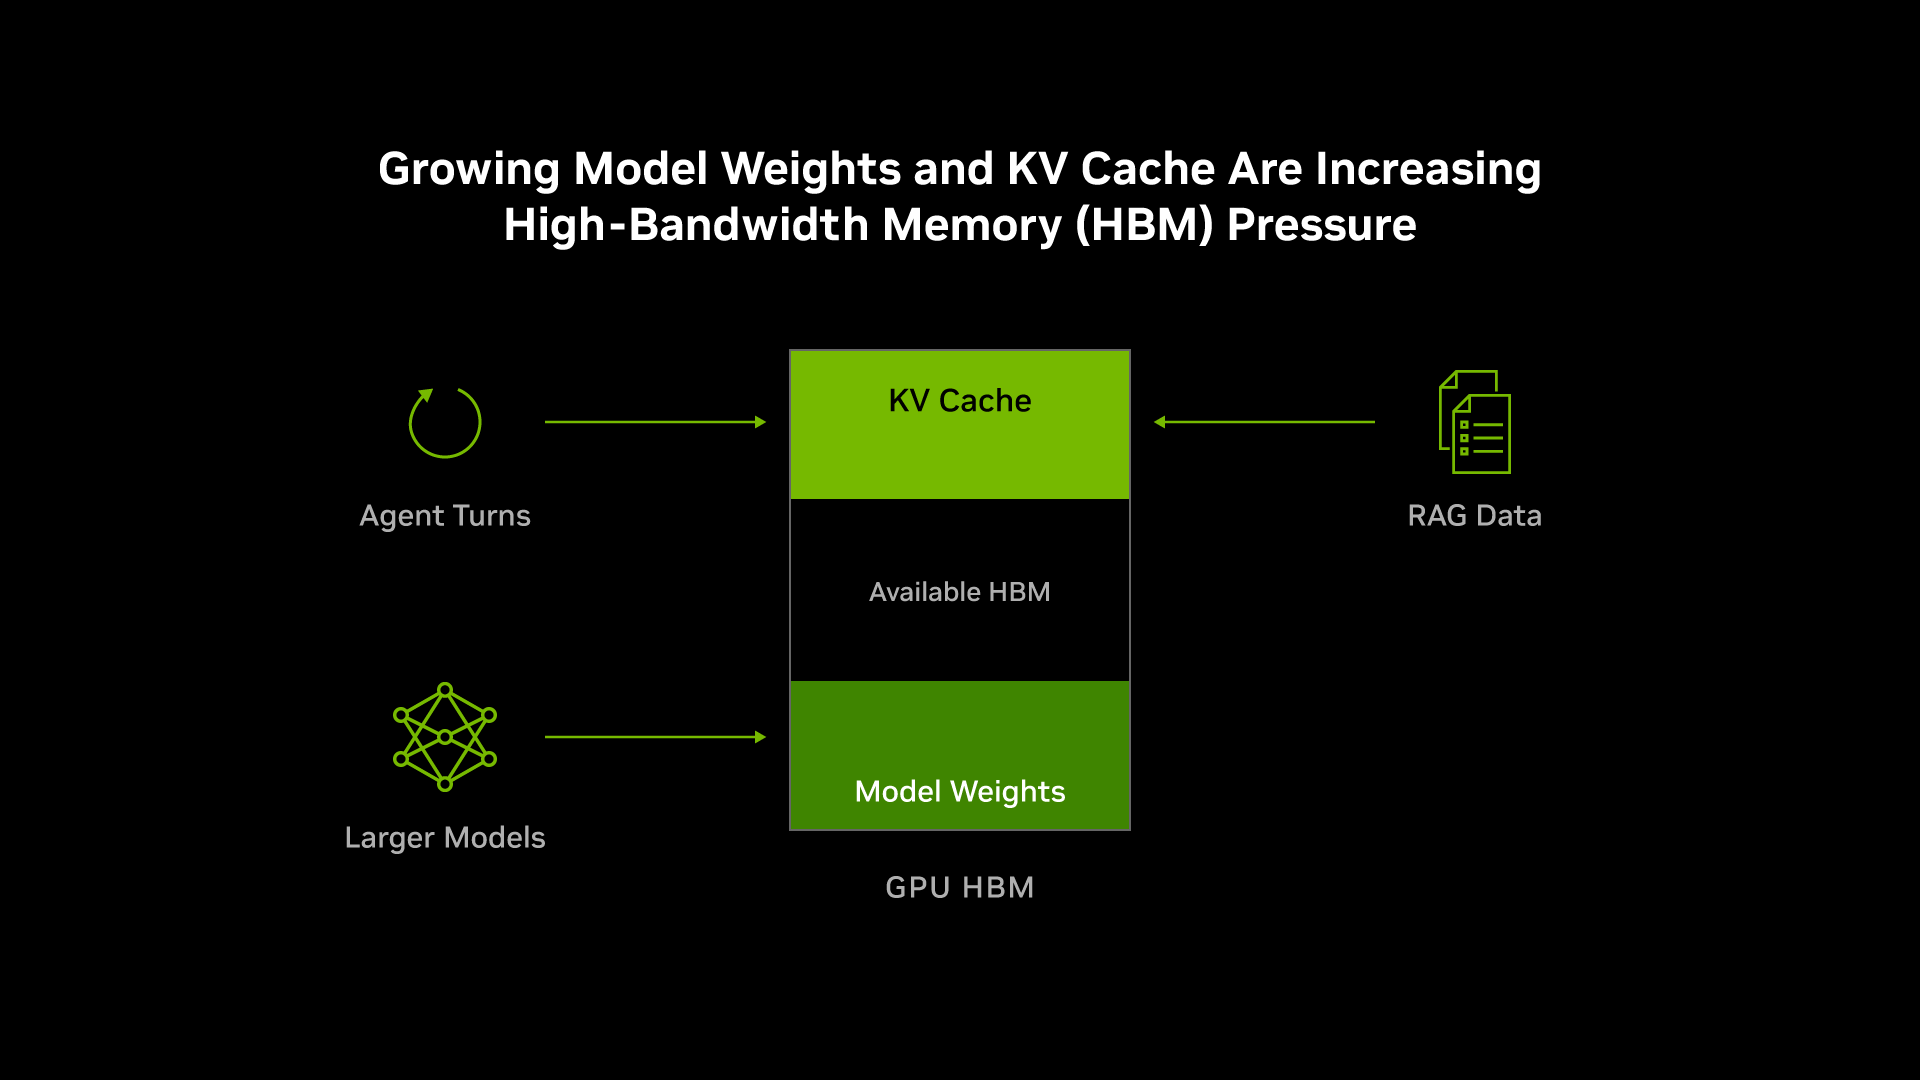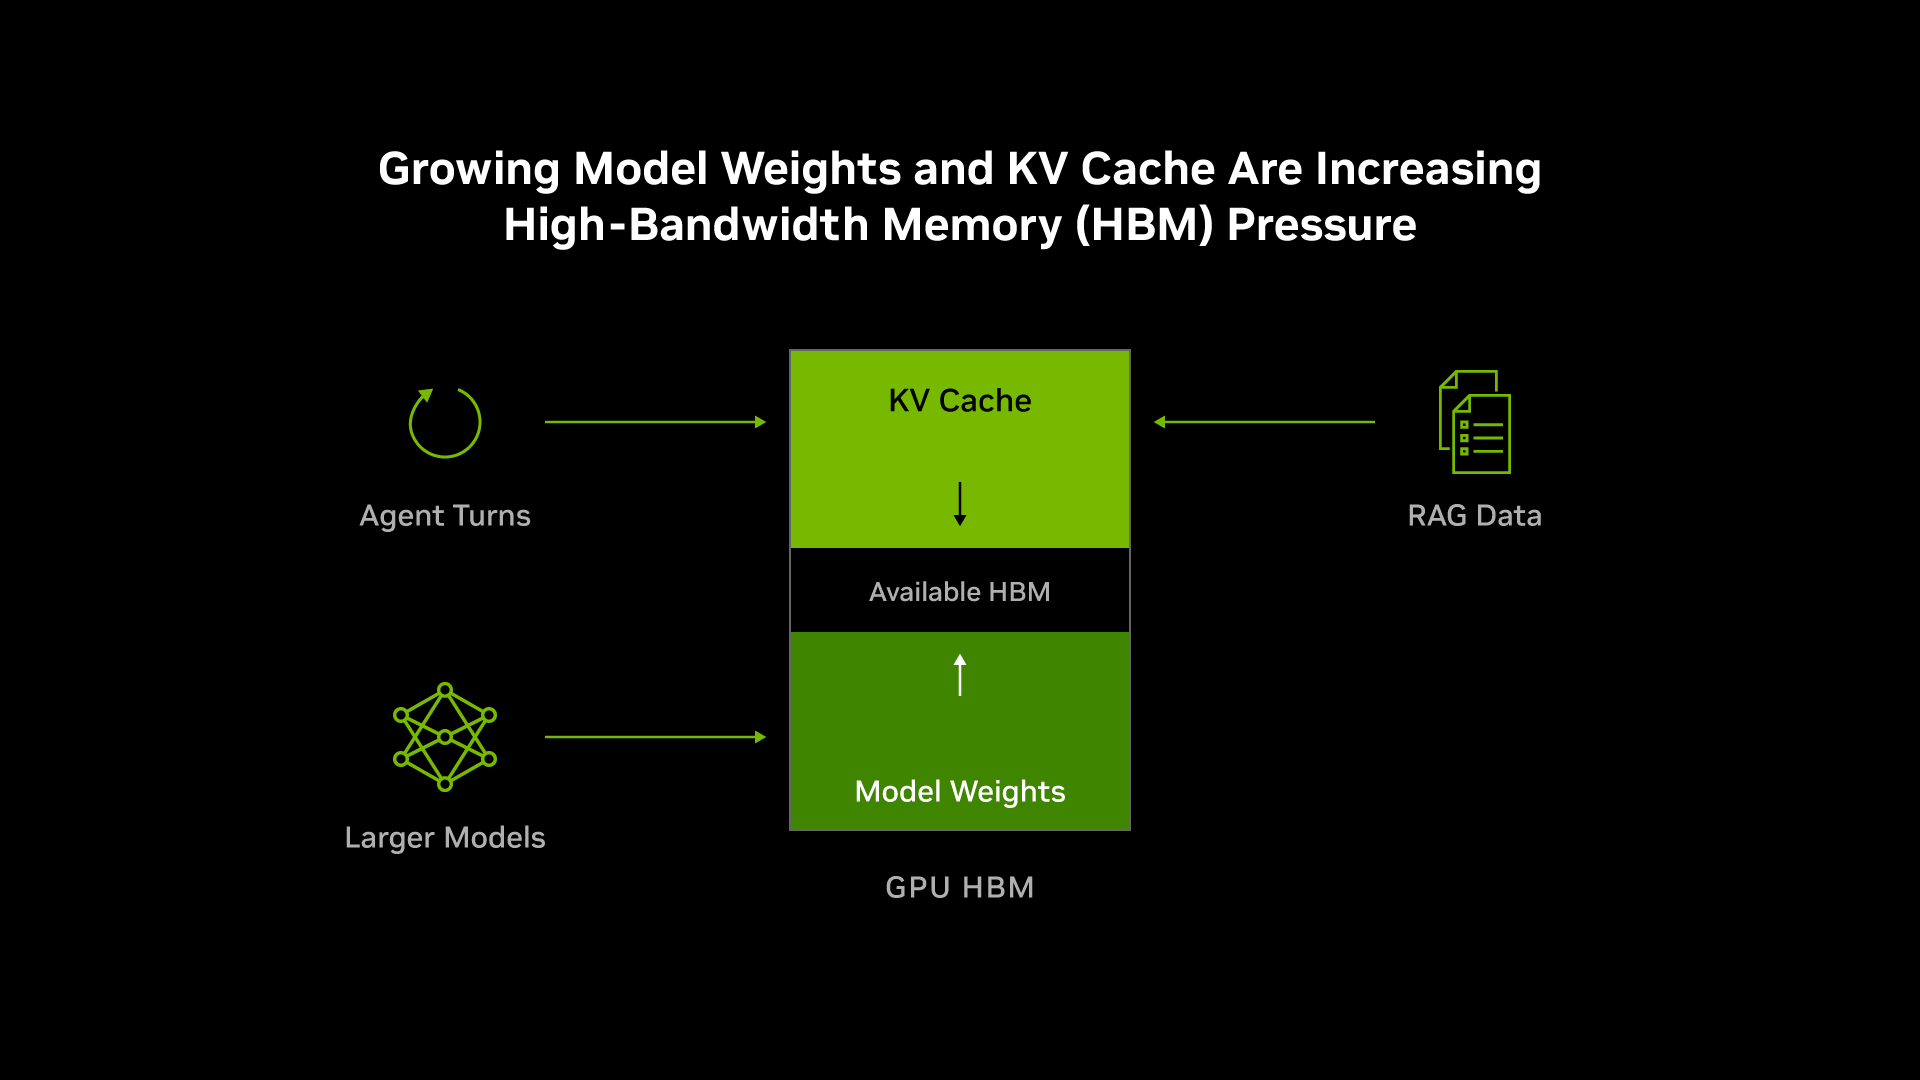
Frontier-Modelle verfügen jetzt über Billionen von Parametern – die Werte, die das speichern, was ein KI-Modell während des Trainings gelernt hat.
Der KV-Cache, der den Kontext enthält, der das Modell benötigt, um jede aktive Anfrage zu verstehen, ohne die gleichen Informationen erneut zu verarbeiten, wird ebenfalls erweitert. Agentische Bewegungsbahnen tragen den vorherigen Kontext über wiederholte Modell- und Tool-Aufrufe hinweg, wobei in einigen Fällen bis zu 3 Millionen Token verarbeitet werden, sodass der Arbeitsspeicher jeder Anfrage im Laufe der Zeit wächst.
Retrieval-Augmented Generation (RAG) fügt Prompts relevante Unternehmensinformationen hinzu und erfordert so noch mehr Kontext, der verarbeitet und gespeichert werden muss.
Während der Inferenz hält HBM in erster Linie sowohl Modellparameter als auch KV-Cache bereit. Das Ergebnis: größerer Druck auf HBM.
Warum KI-Fabriken eine Speicherhierarchie benötigen
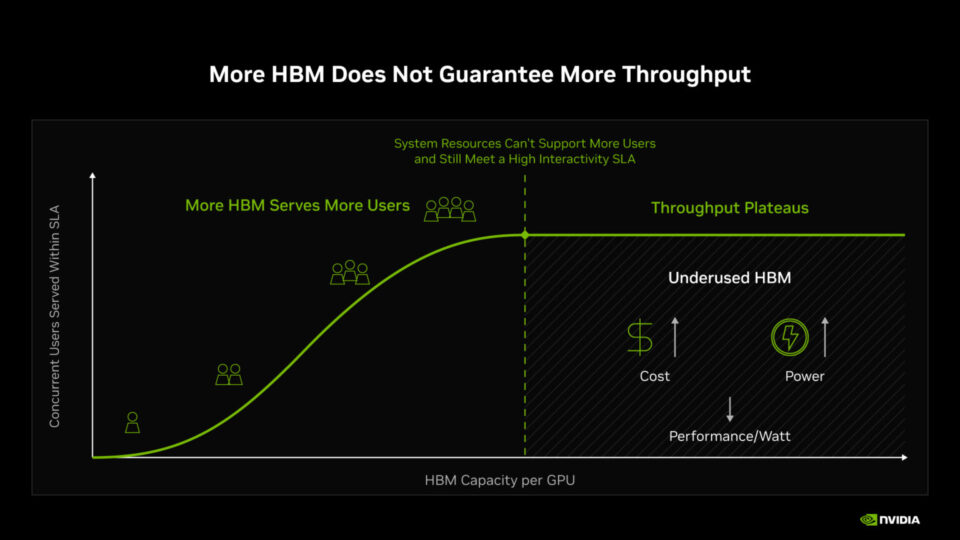
Mehr HBM-Kapazität pro GPU hinzuzufügen ist die offensichtliche Antwort auf diesen Druck, aber die Kapazität liefert nur, was die Bandbreite transportieren kann.
Stellen Sie sich HBM als Lager und Speicherbandbreite als Laderampen vor. Ein größeres Lager fasst mehr Bestand, aber die Docks legen fest, wie viel gleichzeitig ein- und ausgegeben werden kann. Sobald die Kapazität der Docks ausgelastet ist, dauert der Transport von mehr Inventar länger und verlangsamt die Reaktionszeiten. Wenn die Verzögerungen das erforderliche Service-Level überschreiten, kann der zusätzliche Platz nicht effektiv genutzt werden, obwohl er Kosten erhöht und Energie verbraucht.
Deshalb hält auch kein Betrieb sein gesamtes Inventar im nächstgelegenen, schnellsten Speicherbereich vor. Was in Bewegung ist, bleibt in der Nähe der Fertigungslinie. Was wartet, wird in einen größeren, kostengünstigeren Bereich in der Nähe verschoben und kehrt zurück, bevor es benötigt wird.
Eine KI-Fabrik ist mit der gleichen Einschränkung konfrontiert.
Mehr HBM kann mehr KV-Cache speichern und mehr gleichzeitige Benutzer unterstützen. Jeder hinzugefügte Benutzer teilt sich die gleiche Rechen- und Speicherbandbreite. Aber wenn jeder Benutzer schnelle Antworten erwartet, ist die Speicherbandbreite schließlich nicht in der Lage, Daten so schnell bereitzustellen, wie die Rechenleistung sie nutzen kann: eine Grenze, die Ingenieure als Speicherwand bezeichnen.
Nach diesem Zeitpunkt können keine zusätzlichen HBM-Kapazitäten mehr in Anspruch genommen werden, was jedoch die Kosten erhöht und Energie verbraucht. Die Daten benötigen immer noch einen Ort, an dem sie gespeichert werden können, aber nicht alle davon benötigen die schnellste und teuerste Ebene. Aus diesem Grund verwaltet eine KI-Fabrik Daten über eine Speicher- und Datenspeicherhierarchie hinweg.
Maximierung des Werts jedes Bytes mit Full-Stack Codesign
Das Full-Stack-Codesign von NVIDIA sorgt dafür, dass jedes Byte HBM zählt, indem es die Auslastung durch Modellgewichte, KV-Cache und RAG-Daten verringert. Es tut dies mit Techniken, die jeweils eine andere Quelle der Ineffizienz angehen:
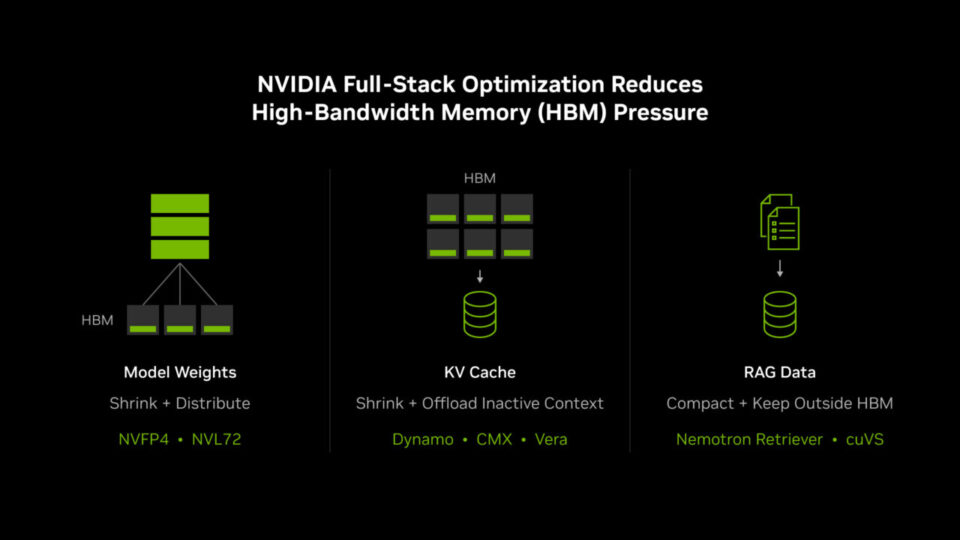
Reduzieren Sie die Modellgewichte und verteilen Sie sie über die NVL72-Domäne.
- Das NVFP4-Format reduziert den Platzbedarf für Gewichte im Vergleich zu FP8, der niedrigsten möglichen Genauigkeit auf der NVIDIA Hopper-Plattform. Kürzliche Modelle, darunter FLUX.2 [klein] von Black Forest Labs, Inkling von Thinking Machines Lab, Beam 1.0 von Reflection, Meta Muse Spark von Meta, Step 5 Preview von StepFun und NVIDIA Nemotron 3.5 Super VL wurden mit NVFP4-Checkpoints veröffentlicht, was die wachsende Akzeptanz von 4-Bit-Genauigkeit bei Modellentwicklern für schnellere, speichereffizientere Inferenz zeigt.
- Innerhalb eines NVL72-Systems können Modellgewichte auf bis zu 72 GPUs verteilt werden, sodass jede GPU einen kleineren Anteil des Modells hält – wodurch mehr HBM für KV-Cache und gleichzeitige Benutzer frei bleibt.
Verkleinern Sie den KV-Cache und lagern Sie inaktiven Kontext auf kostengünstigere Datenspeicherebenen aus.
- Die Anwendung von NVFP4 auf den KV-Cache reduziert seinen Platzbedarf im Vergleich zu FP8, sodass mehr Kontext in HBM verbleiben kann.
- NVIDIA Vera CPU hilft auf zweierlei Weise. Eine schnellere Tool-Ausführung verkürzt die Zeit, in der der KV-Cache während Tool-Aufrufen inaktiv ist, und sein großer LPDDR-Speicher, der über eine NVIDIA NVLink-C2C-Verbindung mit NVIDIA Rubin-GPUs verbunden ist, bietet pausierten Kontexten einen Platz in der Nähe, um dort zu warten und schnell zurückzukehren.
- Wenn der Kontext nicht aktiv verwendet wird, verlagert die Inferenzsoftware NVIDIA Dynamo ihn auf den Kontext-Memory-Datenspeicher von NVIDIA CMX – eine Ebene, die für Kapazität zu weit geringeren Kosten pro Bit als HBM entwickelt wurde – und gibt ihn vor der Wiederverwendung zurück. Im Gegensatz zu lokalen SSDs wird CMX über Server hinweg gemeinsam genutzt. Im Gegensatz zu Unternehmensdatenspeichern überspringt es den Aufwand für langfristigen Datenschutz, den kurzlebige Kontexte nicht benötigen. Zu den NVIDIA CMX Context Memory Datenspeicher-Partnern gehören Cloudian, DDN, Dell Technologies, Everpure (ehemals Pure Storage), HPE, IBM, NetApp, VAST und WEKA.
- Die KV Cache Reuse von Dynamo verbindet die Ebenen und verwaltet den KV-Cache als systemweite Ressource über GPU-Speicher, CPU-Speicher und Datenspeicher hinweg, sodass einmal berechneter Kontext im gesamten System wiederverwendet werden kann.
Kompakte RAG-Einbettungen, die den Index außerhalb von HBM halten.
- RAG verwandelt Unternehmensdokumente in Embeddings – numerische Darstellungen, die es einem System ermöglichen, nach Bedeutung und nicht nach Schlüsselwörtern zu suchen – die in einem durchsuchbaren Index organisiert sind. NVIDIA Nemotron Retriever-Modelle produzieren kleinere Embeddings mit höherer Abrufgenauigkeit, während die NVIDIA cuVS-Bibliothek es ermöglicht, dass dieser Index über CPU und Datenspeicher hinweg entwickelt und bereitgestellt wird. Die Wissensbasis belegt nie HBM, und nur die Passagen, die das Modell benötigt, werden in den Kontext einbezogen.
Das Ergebnis: Weniger HBM für Modellgewichte verwendet, weniger HBM ist durch einen inaktiven Kontext gebunden, und mehr davon steht für die Bereitstellung gleichzeitiger Benutzer zur Verfügung.
Nützlichere Leistung pro Dollar mit jeder Generation
Über aufeinander folgende NVIDIA-Plattformgenerationen hinweg stiegen die Token pro Sekunde pro Dollar viel schneller als die HBM-Kapazität.
Bei dem SemiAnalysis AgentX DeepSeek V4 Pro Workload bietet NVIDIA GB300 NVL72 einen bis zu 10-mal höheren Durchsatz pro Dollar als die NVIDIA H200-Plattform bei 100 Token pro Sekunde und pro Benutzer, wobei sich die HBM-Kapazität pro GPU etwa verdoppelt. Bei 125 Token pro Sekunde pro Benutzer liefert Vera Rubin NVL72 einen bis zu 30-mal höheren Durchsatz pro Dollar als GB300 NVL72, wobei die HBM-Kapazität pro GPU um etwa 3 % höher ist.
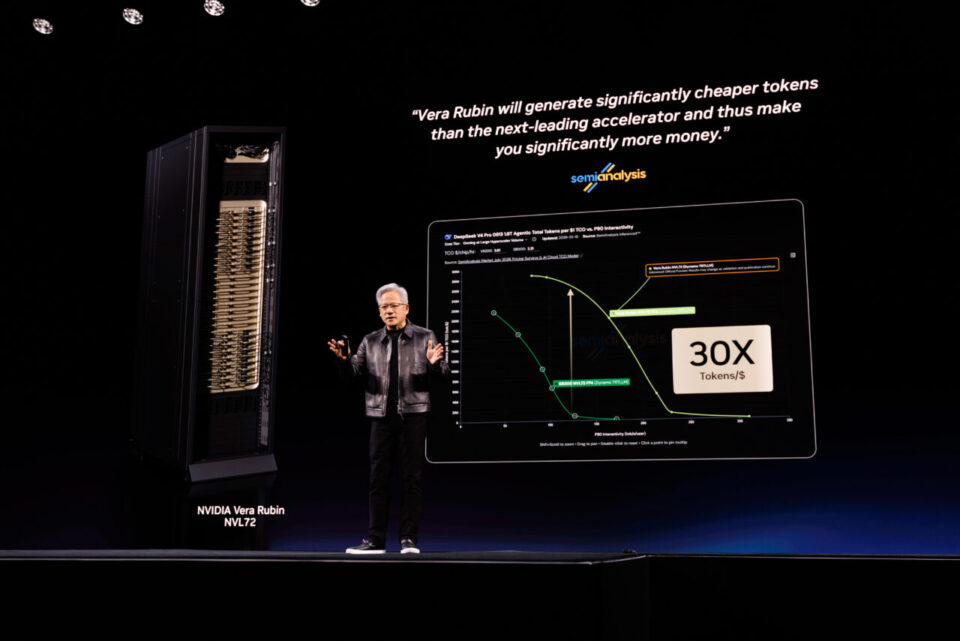
Für Betreiber von KI-Fabriken ist die entscheidende Metrik, wie viele nützliche Token die Fabrik innerhalb ihres Energiebudgets liefern kann und gleichzeitig die Anforderungen der Benutzer an die Reaktionszeit erfüllt. Mehr Token pro Sekunde pro Watt bedeuten mehr Arbeit und Umsatz bei gleichem Energieverbrauch sowie geringere Kosten für jedes Token. Das Full-Stack-Codesign von NVIDIA senkt die Tokenkosten, indem es die nutzbare Arbeit erhöht, die jedes Byte Speicher liefert.
Erfahren Sie mehr im Erklärungsvideo und in den technischen Tiefen darüber, wie NVIDIA Full-Stack-Codesign den Druck auf den Inferenzspeicher reduziert.